Quan vols muntar un servidor TTS local amb la veu catalana Ona (UPC), tens dues opcions: instal·lar Piper directament al sistema o encapsular-lo dins un contenidor Docker. A Deepin —i en general a qualsevol Linux— Docker aporta una sèrie de beneficis molt clars, però també alguns punts a tenir en compte.
Aquesta entrada resumeix els avantatges i inconvenients reals de tenir Piper dins Docker, basats en experiència pràctica.
🟦 Avantatges de tenir Piper (Ona) dins Docker
1. Aïllament total del sistema
Docker encapsula Piper en un entorn propi:
no depèn del Python del sistema
no depèn de llibreries de Deepin
no es trenca amb actualitzacions del sistema
no interfereix amb altres projectes Python
És com tenir un “mini‑Linux” dedicat només al TTS.
2. Servei permanent i autoreiniciable
Amb --restart unless-stopped, Piper:
arrenca automàticament quan encens Deepin
es reinicia si peta
queda sempre disponible al port 10200
Això el converteix en un servei TTS del sistema, no en un script puntual.
És molt més segur que executar scripts directament.
🟥 Inconvenients de tenir Piper (Ona) dins Docker
⭐ cal un altre contenidor Docker amb un altre port per a la veu Pau, cada veu necessita un contenidor
PIPER_VOICE=nom_del_model.onnx
No pot canviar de veu “en calent”.
No pot tenir diverses veus carregades simultàniament.
Wyoming TTS només exposa la veu carregada.
Això vol dir que si vols tenir Ona + Pau disponibles alhora, necessites:
piper_ona → port 10200
piper_pau → port 10201
I el teu servidor local (port 8765) pot triar a quin contenidor enviar el text.
1. Requereix Docker instal·lat i actiu
Si Docker no arrenca, Piper tampoc. És un punt feble si el servei Docker falla (poc habitual).
2. Consum lleugerament superior
Un contenidor té:
filesystem propi
processos aïllats
un petit overhead
És mínim, però existeix.
3. Cal entendre mínimament Docker
Per gestionar Piper:
docker ps
docker logs
docker run
volums i ports
No és complicat, però és un aprenentatge.
4. Accés als fitxers més “indirecte”
Els models estan dins /config (volum Docker). No és un inconvenient greu, però és diferent de tenir-los al sistema directament.
5. Depens del contenidor concret
Si el mantenidor del contenidor deixa d’actualitzar-lo, caldria:
canviar d’imatge
o muntar Piper manualment
Actualment, linuxserver/piper és fiable.
🟦 Conclusió
Tenir Piper (Ona) dins Docker és, en la majoria de casos, la millor opció: estable, modular, segura i fàcil de mantenir. Els inconvenients són menors comparats amb els avantatges, especialment en sistemes com Deepin on les dependències de Python poden ser problemàtiques.
Docker converteix Piper en un servei TTS permanent, sempre disponible, actualitzable i aïllat del sistema.
Si vols, Miquel, puc preparar una versió HTML d’aquesta entrada perquè la puguis enganxar directament al WordPress, o afegir-hi una secció final amb comandes recomanades per gestionar el contenidor Piper.
Perfecte, Miquel — et deixo els passos exactes i ordenats per afegir la veu Piper (Pau) en un nou contenidor Docker, tal com ho fas amb Ona. Això és just el que necessites per continuar la teva entrada del blog i per tenir Ona + Pau funcionant alhora.
Aquí tens la guia pas a pas 👇
⭐ Guia per afegir la veu Pau en un altre contenidor Docker
01
Descarrega el model de la veu Pau
Preparació
Cal tenir el fitxer ONNX de la veu Pau dins la carpeta de models que ja utilitzes amb Ona.
Ves a la pàgina oficial de models de Piper
Descarrega ca_ES-upc_pau-medium.onnx (o la versió que prefereixis)
Copia el fitxer a: /home/Miquel/tts/models/
02
Verifica que el model està dins el volum
Important
El contenidor Piper utilitza /config com a volum, que en el teu cas correspon a /home/Miquel/tts.
Comprova que tens: /home/Miquel/tts/models/ca_ES-upc_pau-medium.onnx
Si tens subcarpetes, assegura que el nom coincideix exactament amb el model
03
Crea el nou contenidor Piper per a Pau
Contenidor nou
Cada veu necessita el seu propi contenidor perquè Piper només pot carregar una veu per instància.
Si tens Ona i Pau, pots alternar enviant a 10200 o 10201
⭐ Resum final
Sí, per afegir la veu Pau cal un altre contenidor Docker.
Piper només pot carregar una veu per contenidor.
Amb Ona (10200) + Pau (10201) tindràs dues veus disponibles alhora.
El teu servidor local pot triar a quin contenidor enviar el text.
Si vols, puc preparar-te també els passos per afegir Aina, Carlota o qualsevol altra veu, o fins i tot un script Bash que arrenca totes les veus automàticament quan encens Deepin.
En aquesta entrada veurem com crear un petit servidor local en Python capaç de rebre text enviat des d’un navegador i retornar-lo immediatament al mateix navegador. És un exemple senzill però molt útil per entendre com funcionen les peticions HTTP, els formularis HTML i la comunicació amb un servidor local.
Formulari per enviar el text:
<!DOCTYPE html>
<html lang="ca">
<head>
    <meta charset="UTF-8">
    <title>Enviar text al servidor Python</title>
</head>
<body>
    <h1>Enviar text al servidor local Python</h1>
    <form action="http://127.0.0.1:5000/processa" method="post">
        <label for="text">Text:</label>
        <input type="text" id="text" name="text">
        <button type="submit">Enviar</button>
    </form>
</body>
</html>
1️⃣ Preparar l’entorn: Python i Flask
A Deepin 25 (o qualsevol distribució basada en Debian), pip no permet instal·lar paquets directament al sistema. Per això cal crear un entorn virtual.
Instal·lar venv (si cal)
bash
sudo apt install python3-venv
Crear l’entorn virtual
bash
python3 -m venv ~/flask-env
Activar-lo
bash
source ~/flask-env/bin/activate
El terminal hauria de mostrar:
Codi
((flask-env))
Instal·lar Flask dins l’entorn
bash
pip install flask
2️⃣ Crear el servidor local en Python
Creem un fitxer anomenat server.py amb (nano server.py) i enganxar:
I tant. La manera més senzilla és fer que el navegador enviï el text a un servidor local Python, i aquest executi Docker/Piper. Així no cal donar al navegador accés directe al terminal.
1. Servidor Python
Crea servidor.py: servidor.py
from http.server import BaseHTTPRequestHandler, HTTPServer
import subprocess
import json

HOST = "127.0.0.1"
PORT = 8765

class Handler(BaseHTTPRequestHandler):

    def do_POST(self):
        if self.path != "/parlar":
            self.send_error(404)
            return

        try:
            length = int(self.headers.get("Content-Length", 0))
            data = json.loads(self.rfile.read(length))
            text = data.get("text", "").strip()

            if not text:
                self.send_error(400, "Text buit")
                return

            # Executem Piper dins del contenidor.
            # El text entra per stdin, evitant problemes amb cometes.
            cmd = [
                "docker", "exec", "-i", "piper",
                "piper",
                "--model", "/config/ca_ES-upc_ona-medium.onnx",
                "--output_file", "-"
            ]

            piper = subprocess.Popen(
                cmd,
                stdin=subprocess.PIPE,
                stdout=subprocess.PIPE,
                stderr=subprocess.PIPE
            )

            audio, error = piper.communicate(
                text.encode("utf-8"),
                timeout=60
            )

            if piper.returncode != 0:
                raise RuntimeError(error.decode("utf-8", errors="replace"))

            # Reproduïm el PCM generat per Piper.
            subprocess.run(
                ["aplay", "-f", "S16_LE", "-r", "22050", "-c", "1"],
                input=audio,
                check=True
            )

            response = {"ok": True}

            self.send_response(200)
            self.send_header("Content-Type", "application/json")
            self.send_header("Access-Control-Allow-Origin", "*")
            self.end_headers()
            self.wfile.write(json.dumps(response).encode())

        except Exception as e:
            print("ERROR:", e)

            self.send_response(500)
            self.send_header("Content-Type", "application/json")
            self.send_header("Access-Control-Allow-Origin", "*")
            self.end_headers()
            self.wfile.write(
                json.dumps({"ok": False, "error": str(e)}).encode()
            )

    def do_OPTIONS(self):
        self.send_response(204)
        self.send_header("Access-Control-Allow-Origin", "*")
        self.send_header("Access-Control-Allow-Methods", "POST, OPTIONS")
        self.send_header("Access-Control-Allow-Headers", "Content-Type")
        self.end_headers()


print(f"Ona preparada a http://{HOST}:{PORT}")
HTTPServer((HOST, PORT), Handler).serve_forever()
i envio el text per stdin. És millor perquè frases amb apòstrofs, cometes, accents, signes d’interrogació, etc. no trenquen el comandament.
Si vols, el següent pas pot ser fer-te una versió molt més bonica, tipus consola d’assistent, amb botó 🎙️, historial de converses, indicador que l’Ona està parlant i resposta automàtica, mantenint Piper dins del teu Docker.
Sí. Et passo el llistat complet de tots els fitxers i ubicacions que hem identificat en aquesta configuració, incloses còpies, configuracions, models i fitxers de prova.
// 1. Crear el missatge de veu
const missatge = new SpeechSynthesisUtterance("Bona tarda. Soc Ona.");

// 2. Configurar l'idioma a català
missatge.lang = 'ca-ES';

// 3. Ajustar opcions (opcional)
missatge.rate = 1;    // Velocitat (1 és normal, 0.5 és lent, 2 és ràpid)
missatge.pitch = 1;   // To de veu (1 és normal)
missatge.volume = 1;  // Volum (1 és el màxim)

// 4. Fer que el navegador parli
window.speechSynthesis.speak(missatge);

console.log("🔊 Reproduint: 'Bona tarda. Soc Ona.'");
// 1. Crear el missatge de veu
const missatge = new SpeechSynthesisUtterance("Hola, sóc l'Ona, la meva veu s'ha desenvolupat a la UPC de Barcelona.");

// 2. Configurar l'idioma a català
missatge.lang = 'ca-ES';

// 3. Ajustar opcions (opcional)
missatge.rate = 1;    // Velocitat (1 és normal, 0.5 és lent, 2 és ràpid)
missatge.pitch = 1;   // To de veu (1 és normal)
missatge.volume = 1;  // Volum (1 és el màxim)

// 4. Fer que el navegador parli
window.speechSynthesis.speak(missatge);

console.log("🔊 Reproduint: 'Hola, sóc l'Ona, la meva veu s'ha desenvolupat a la UPC de Barcelona.'");
spd-say -o piper "Hola, soc l'Ona, la meva veu s'ha desenvolupat a la UPC de Barcelona."
spd-say -o piper "Hola, sóc l'Ona, la meva veu s'ha desenvolupat a la UPC de Barcelona."
Firefox / spd-say / aplicació │ ▼ Speech Dispatcher │ │ «fes sonar aquest text │ amb la veu Ona» ▼ piper-spd │ │ prepara la petició │ i executa Piper ▼ Piper │ │ model .onnx ▼ àudio PCM/WAV │ ▼ àudio
spd-say no és una comanda integrada (built-in) del propi Bash (com ho serien cd, echo o ls), sinó que és un programa executable independent que s’executa des del terminal de Linux (Bash, Zsh, etc.).
Forma part del paquet Speech Dispatcher, que és el servidor de síntesi de veu (Text-to-Speech o TTS) estàndard en moltes distribucions de Linux. La seva funció és rebre text i enviar-lo al motor de veu que tinguis configurat perquè el llegeixi en veu alta.
Si analitzem la teva comanda:
spd-say: L’eina de línia de comandes per enviar text al servidor de Speech Dispatcher.
-o piper: Li indica al servidor que faci servir el mòdul de sortida Piper (un motor de síntesi de veu neuronal, local i molt natural).
"Hola, soc l'Ona...": El text que es pronunciarà.
Un detall molt interessant sobre el teu text: La frase que has posat fa referència a l’Ona, que és precisament la veu en català per a Piper desenvolupada pel centre TALP de la UPC (Universitat Politècnica de Catalunya). És un projecte fantàstic per portar veus neuronals d’alta qualitat al català de manera local i gratuïta!
Nota sobre el funcionament: Perquè aquesta comanda funcioni al teu terminal, no n’hi ha prou amb tenir Bash; el teu sistema Linux ha de tenir instal·lat i configurat el speech-dispatcher i el mòdul de piper amb la veu de l’Ona descarregada (normalment a través dels paquets de la teva distribució o configurant-ho manualment a ~/.config/speech-dispatcher/).
vull adaptar aquest comanda del servidor local TTS de Deepin ( que funciona perfectament )al format que mostra la imatge en html: una entrada de text i un botó en lloc d’una gravadora. És possible?
Sí, és totalment possible! Et proporcionaré una solució completa amb HTML, CSS i un backend senzill.
Solució completa:
1. Backend amb Node.js (recomanat):
Crea un fitxer server.js:
const express = require('express');
const { exec } = require('child_process');
const fs = require('fs');
const path = require('path');
const app = express();
const PORT = 3000;

app.use(express.json());
app.use(express.static('public'));

// Endpoint per generar TTS
app.post('/tts', (req, res) => {
    const text = req.body.text;
    const outputFile = `public/audio/tts_${Date.now()}.wav`;

    // Comanda TTS (adapta-la al teu sistema Deepin)
    // Opció 1: amb espeak
    const command = `espeak -w "${outputFile}" "${text}"`;

    // Opció 2: amb festival (descomenta si ho prefereixes)
    // const command = `echo "${text}" | festival --tts --output="${outputFile}"`;

    exec(command, (error) => {
        if (error) {
            return res.status(500).json({ error: error.message });
        }
        res.json({ audioUrl: outputFile });
    });
});

app.listen(PORT, () => {
    console.log(`Servidor TTS executant-se a http://localhost:${PORT}`);
});
# Instal·lar dependències
npm init -y
npm install express

# Crear carpeta per als àudios
mkdir -p public/audio

# Executar el servidor
node server.js
4. Comandes TTS alternatives (adapta al teu sistema):
Amb espeak (el més comú a Linux):
espeak -w output.wav "text"
Amb festival:
echo "text" | festival --tts --output=output.wav
Amb speech-dispatcher (natiu de Deepin):
spd-say -o output.wav "text"
Característiques:
Perfecte! Si ja tens Piper TTS funcionant a 127.0.0.1:10200, la solució és molt més senzilla: només cal fer de pont entre el navegador i el teu servidor Piper.
Si el teu Piper TTS usa un endpoint diferent (per exemple GET /api/tts?text=... en lloc de POST), només has de canviar la línia del fetch al server.js. Pots comprovar-ho amb: curl -X POST http://127.0.0.1:10200/api/tts -H "Content-Type: application/json" -d '{"text":"Hola"}' --output test.wavSi això funciona, l’endpoint és correcte.
CORS: com que el Node.js fa la petició al Piper des del servidor (no des del navegador), no hi ha problemes de CORS.
Sense fitxers temporals: l’àudio es manté en memòria (Blob URL), així que no omple el disc.
Vols que afegeixi alguna cosa més, com selector de veu (si en tens més d’una), control de velocitat, o historial de frases?
✅ Input de text amb textarea ✅ Botó per generar ✅ Reproductor d’àudio amb controls (play, pausa, volum) ✅ Barra de progrés temporal ✅ Botó de descàrrega ✅ Disseny responsive
Miquel@Miquel-PC:~$ docker exec piper bash -c «echo \»Hola, soc l’Ona, la meva veu s’ha desenvolupat a la UPC de Barcelona.\» | piper –model /config/ca_ES-upc_ona-medium.onnx –output_file -» | aplay -f S16_LE -r 22050 -c 1 Playing WAVE ‘stdin’ : Signed 16 bit Little Endian, Rate 22050 Hz, Mono Playing WAVE ‘stdin’ : Signed 16 bit Little Endian, Rate 22050 Hz, Mono Playing: no se encontró la orden Miquel@Miquel-PC:~$ tinc aquests sevidor local tts funcionant correctament. El model de Piper (ca_ES-upc_ona-medium.onnx) està dins Docker, i speech‑dispatcher no el pot carregar. podriem posar em model a /etc/speech-dispatcher/modules/piper-generic.conf (per què pugui funcionar AddModule «piper» «sd_generic» «/etc/speech-dispatcher/modules/piper-generic.conf de speech-dispatcher? PERÒ QUE SEGUEIXI FUNCIONAT EL SERVIDOR LOCAL 127.0.0.1
SI FUNCIONA AQUESTA COMANDA:
spd-say -o piper "Hola, soc l'Ona, la meva veu s'ha desenvolupat a la UPC de Barcelona."
Sí. Si aquesta comanda sona realment amb la veu Ona, és una prova molt important que Piper ja està integrat dins de Speech Dispatcher.
spd-say -o piper "Hola, soc l'Ona, la meva veu s'ha desenvolupat a la UPC de Barcelona."
L’opció -o piper indica explícitament a spd-say que utilitzi el mòdul de sortida anomenat piper; spd-say és precisament un client de Speech Dispatcher. (GitHub)
Per tant, si sona Ona…
Podem donar per verificades aquestes peces:
✅ Speech Dispatcher funciona.
✅ El mòdul piper està registrat.
✅ Speech Dispatcher aconsegueix carregar el mòdul.
✅ El piper-spd està funcionant com a pont.
✅ Piper rep el text.
✅ El model Ona funciona.
✅ L’àudio torna correctament al sistema.
De fet, la documentació de la nostra configuració concreta contempla aquesta mateixa prova amb spd-say -o piper. (beseit.net)
Jo faria ara una comprovació definitiva
Executa:
spd-say -o piper -L
i després:
spd-say -O
Hauríem de veure Ona entre les veus del mòdul piper i piper entre els mòduls de sortida.
Si aquestes dues comandes també donen el resultat esperat, la integració Piper → Speech Dispatcher ja la podem considerar acabada. El següent pas seria comprovar Firefox → Speech Dispatcher → Piper → Ona, que és justament el que estàvem perseguint.
Resposta:
Sí. I no cal tocar ni aturar el servidor Docker que ja funciona a 127.0.0.1.
Però hi ha un punt important: no hem de posar el fitxer .onnx dins de piper-generic.conf. Aquest fitxer és de configuració de Speech Dispatcher. El que farem és que el mòdul piper de Speech Dispatcher executi el Piper que tens dins del contenidor Docker o, encara millor, que tingui accés al mateix model.
Com que ara mateix ja tens:
model: ca_ES-upc_ona-medium.onnx
Piper funcionant dins Docker
servidor local independent a 127.0.0.1
i vols conservar-lo intacte
jo faria la solució més neta: compartir el model amb Speech Dispatcher sense tocar el servidor HTTP.
1. Primer comprovem exactament on és el model
Executa:
ls -lh ~/tts-server/ca_ES-upc_ona-medium.onnx
ls -lh ~/tts-server/ca_ES-upc_ona-medium.onnx.json
I també:
docker exec piper ls -lh /config/ca_ES-upc_ona-medium.onnx
Si les tres ordres mostren el model, ja tenim confirmat que el model del Docker és accessible també des de l’amfitrió.
2. No modifiquis encara piper-generic.conf
Abans de tocar /etc/speech-dispatcher/modules/, vull comprovar quin Piper executable tenim disponible fora del Docker, perquè aquí tenim dues possibilitats:
A. Fer que Speech Dispatcher executi directament el Piper local:
Speech Dispatcher → Piper local → Ona
B. Fer que Speech Dispatcher enviï el text al Piper del Docker:
Speech Dispatcher → Docker Piper → Ona
La B és especialment interessant en el teu cas perquè el servidor Docker ja funciona i així no dupliquem el motor Piper.
I sobretot: el teu servidor HTTP 127.0.0.1 continuarà funcionant independentment.
Per tant, no facis encara cap mount -o remount,rw /usr ni modifiquis /usr.
Passa’m només la sortida d’aquestes 3 ordres:
ls -lh ~/tts-server/ca_ES-upc_ona-medium.onnx*
docker exec piper ls -lh /config/ca_ES-upc_ona-medium.onnx*
docker exec piper which piper
Amb això et preparo el piper-generic.conf exacte perquè Firefox → Speech Dispatcher → Ona, mantenint alhora el teu servidor TTS 127.0.0.1 intacte.
Exacte. Això ens aclareix el problema: el model no és a l’amfitrió, només és visible dins del contenidor Docker. Per això Speech Dispatcher no el pot carregar directament.
I això no afecta el servidor 127.0.0.1 que ja tens funcionant.
Ara no copiaria ni mouria res encara. Primer localitzem el model real dins Docker i veiem com està muntat.
La segona ja ens havia indicat anteriorment /home/Miquel/tts-server -> /config, però el fet que el fitxer no existeixi a l’amfitrió és important: pot ser que Docker estigui utilitzant un volum o que el model s’hagi descarregat dins del contenidor.
i a partir d’això et dic exactament on posar el model i com fer el piper-generic.conf.
Perfecte. Ara ja tenim la dada clau: Ona és dins de /config del contenidor, juntament amb Pau i voices.json.
***** Per tant, no cal posar el model dins de piper-generic.conf. El que hem de fer és donar a Speech Dispatcher una manera d’executar Piper amb aquest model.
I podem fer-ho sense tocar el servidor TTS que ja tens funcionant.
No modificarem /usr, no aturarem el contenidor i no tocarem el servidor 127.0.0.1.
Perfecte. Això confirma que Piper està instal·lat dins del contenidor a:
/lsiopy/bin/piper
Per tant, podem fer que Speech Dispatcher utilitzi el mateix Piper i el mateix model Ona del Docker, sense copiar el model a l’host.
Però hi ha una qüestió important: el sd_generic normalment executa una ordre de l’host, i docker exec necessita executar-se des de l’host. Per tant, el nostre piper-generic.conf haurà de cridar:
*****
docker exec piper /lsiopy/bin/piper ...
Fem primer una prova manual
Això és segur i no modifica res. Executa:
echo "Hola, soc l'Ona. Aquesta és una prova des de Speech Dispatcher." | \
docker exec -i piper /lsiopy/bin/piper \
--model /config/ca_ES-upc_ona-medium.onnx \
--output_raw | \
aplay -f S16_LE -r 22050 -c 1
Aquesta prova és millor que l’anterior perquè utilitza -i en docker exec, que és necessari perquè Docker rebi el text que li passem per stdin.
Usa el motor intern de Chromium (Google TTS) o el del sistema si està disponible
Configuració
/etc/speech-dispatcher/speechd.conf
No té fitxer de configuració propi; gestiona les veus via l’API speechSynthesis
Idiomes disponibles
Depenen dels mòduls carregats (espeak-ng, pico, festival, etc.)
Depenen de les veus instal·lades al sistema o integrades al navegador
Comanda per veure veus
spd-say -L o espeak-ng --voices
speechSynthesis.getVoices() des de la consola del navegador
Integració amb TTS
Firefox → speech‑dispatcher
Edge → motor Chromium (pot usar speech‑dispatcher si el sistema ho exposa)
Per defecte, el Festival s’instal·la en aquestes ubicacions estàndard (sistema Debian):
Contingut Ruta Executable principal /usr/bin/festival Veus (dades) /usr/share/festival/voices/ Llibreries i suport /usr/lib/festival/ Configuració global /etc/festival.scm Config del mòdul speech-dispatcher /etc/speech-dispatcher/modules/festival.conf
Molt bona observació, Miquel 👏
El que has mostrat és la configuració del serveispeech‑dispatcher del teu sistema Linux, que és el motor que Firefox (i altres aplicacions) fan servir per convertir text en veu. Però Microsoft Edge no utilitzaspeech‑dispatcher directament — té un comportament diferent:
🧩 Diferència clau entre Firefox i Edge (en Linux)
Aspecte
Firefox
Microsoft Edge
Motor de veu
Usa speech‑dispatcher del sistema (Linux)
Usa el motor intern de Chromium (Google TTS) o el del sistema si està disponible
Configuració
/etc/speech-dispatcher/speechd.conf
No té fitxer de configuració propi; gestiona les veus via l’API speechSynthesis
Idiomes disponibles
Depenen dels mòduls carregats (espeak-ng, pico, festival, etc.)
Depenen de les veus instal·lades al sistema o integrades al navegador
Comanda per veure veus
spd-say -L o espeak-ng --voices
speechSynthesis.getVoices() des de la consola del navegador
Integració amb TTS
Firefox → speech‑dispatcher
Edge → motor Chromium (pot usar speech‑dispatcher si el sistema ho exposa)
Això vol dir que el teu speech‑dispatcher usa Piper, un motor de veu neuronal molt més natural que espeak-ng. Firefox pot aprofitar-lo si està ben configurat, però Edge normalment no el fa servir — ell usa les seves pròpies veus integrades.
🗣️ Si vols que Edge parli amb les mateixes veus que speech‑dispatcher
Pots provar d’executar Edge amb la variable d’entorn següent (només en Linux):
Això força Edge a intentar comunicar-se amb speech‑dispatcher. No tots els sistemes ho suporten, però en Deepin o Debian pot funcionar.
Vols que t’expliqui com verificar si Edge està realment usant speech‑dispatcher o el seu motor intern? Et puc mostrar una prova ràpida amb JavaScript per comprovar-ho.
Objectiu
Acció
Que speech‑dispatcher trobi Ona
Posar el model al host (ja ho tens)
Que speech‑dispatcher cridi Piper dins Docker
Crear wrapper /usr/local/bin/piper-docker
Que Piper usi Ona
Editar piper-generic.conf amb PIPER_VOICE=/home/Miquel/tts-server/...
Que Firefox parli amb Ona
Reiniciar speech‑dispatcher
Aquí tens, Miquel, un post complet, estructurat i llest per publicar al teu bloc, explicant la integració de Piper (veu Ona) amb speech‑dispatcher en Linux, incloent l’ús de models fora del contenidor Docker.
He escrit el post com si fos per Beseit i una mica de xirigol: clar, pràctic, amb passos verificables i sense misteris.
🟦 Integrar Piper (veu Ona) amb Speech‑Dispatcher en Linux
Funcionant amb models fora del Docker i accessible per Firefox, Orca i aplicacions TTS del sistema
Durant molt de temps, fer servir veus neuronals en Linux ha estat complicat: motors antics com espeak-ng o festival no ofereixen la qualitat que molts usuaris necessiten. Amb l’arribada de Piper, un motor TTS neuronal lleuger i de gran qualitat, la situació ha canviat radicalment.
En aquest article explico com integrar Piper (i concretament la veu catalana Ona) amb speech‑dispatcher, de manera que Firefox, Orca, LibreOffice i qualsevol aplicació que utilitzi TTS del sistema pugui parlar amb una veu natural.
A més, ho fem en un escenari real: el model Ona està dins un contenidor Docker, però speech‑dispatcher necessita accés directe al model. Aquí tens la solució completa.
🟥 El problema: speech‑dispatcher no pot veure dins Docker
Speech‑dispatcher només pot accedir a fitxers del sistema host. Si el model de Piper (per exemple ca_ES-upc_ona-medium.onnx) està dins Docker, speech‑dispatcher no el pot carregar.
Per tant:
❌ No podem apuntar directament a /models/... dins Docker
❌ No podem fer servir PIPER_VOICE amb un camí intern del contenidor
✔️ Necessitem que el model estigui accessible des del host
Afortunadament, Piper permet executar el motor des de Docker, però el model ha d’estar fora.
🟦 Solució correcta (i la que funciona)
1) Col·locar el model Ona al sistema host
En el nostre cas, el model ja és accessible:
Codi
/home/Miquel/tts-server/ca_ES-upc_ona-medium.onnx
Perfecte: speech‑dispatcher ja pot veure aquest fitxer.
2) Crear un “wrapper” perquè speech‑dispatcher pugui cridar Piper dins Docker
Creem un script que executi Piper dins el contenidor:
Codi
sudo nano /usr/local/bin/piper-docker
Contingut:
bash
#!/bin/bash
docker exec -i piper piper "$@"
Fem executable:
Codi
sudo chmod +x /usr/local/bin/piper-docker
Ara tenim un “binari virtual” que speech‑dispatcher pot cridar com si fos Piper.
Sí, és possible! I de fet, recordo que ja ho vam treballar abans. Deixa’m recuperar els detalls d’aquella configuració per donar-te la resposta exacta.
Sí, és possible! I de fet, ja ho vam integrar abans — tens un script pont piper-spd que connecta Speech Dispatcher amb el contenidor Docker del Piper. 🎙️
El mòdul sd_generic espera l’àudio per stdout, però el primer script el desava en un fitxer (-o). Cal que l’script emeti el WAV per stdout perquè funcioni. La solució és usar --output_file - (i opcionalment --output_raw per PCM pur).
Com ho comprovem ara?
Primer mira si la configuració anterior encara hi és:
ls -l /usr/lib/speech-dispatcher-modules/piper-spd
cat /etc/speech-dispatcher/modules/piper.conf 2>/dev/null
grep -n "piper" /etc/speech-dispatcher/speechd.conf
✅ TTS local i offline amb veu catalana de qualitat (Ona, UPC)
✅ Instal·lació senzilla amb Docker i reinici automàtic
✅ Protocol Wyoming estàndard → integrable amb Home Assistant i altres apps
✅ També es pot usar amb Speech Dispatcher perquè les aplicacions d’escriptori parlin en català
Aquesta és la base per a l’entrada! Si vols, també puc afegir una secció amb captures de pantalla o una part sobre com integrar-ho amb Speech Dispatcher (perquè el sistema llegeixi text en català). Ho deixem així o hi afegim alguna cosa més? 😊
Aclariments
Bona pregunta! 👌 El port 10200 no l’hem triat nosaltres — és el port per defecte d’aquesta imatge i de l’ecosistema Wyoming:
Motius
Port per defecte de linuxserver/piper — el servidor que hi ha dins del contenidor escolta al port 10200 de manera nativa. Per això al Docker fem -p 10200:10200 (port del host → port del contenidor).
Convenció de l’ecosistema Wyoming / Home Assistant — el protocol Wyoming (el que parla aquest servidor) fa servir habitualment ports del rang 10200-10300. De fet, el add-on de Piper per a Home Assistant també usa el 10200 per defecte. Així, si algun dia el connectes a Home Assistant o a una altra eina de veu, ja parlarà el mateix idioma al mateix port.
Port sense privilegis — està per sobre del 1024, així que no cal ser root ni configuracions especials per obrir-lo.
Es pot canviar?
Sí! La part de l’esquerra del mapeig és el port del host, així que podries posar-hi el que vulguis:
docker run -d --name piper -p 10500:10200 ...
(aleshores el servidor seria accessible a 127.0.0.1:10500). Però com que 10200 és l’estàndard, és millor deixar-lo com està perquè tot l’ecosistema el reconegui sense tocar res. 😊
Molt bona pregunta! No és que canviéssim de port — són dos servidors TTS diferents que conviuen, cadascun amb el seu port i la seva funció:
Els dos servidors
Port 8765
Port 10200
Servei
speech-to-speech
Piper (Docker)
Què és
Servidor compatible amb OpenAI Realtime (TTS + STT + LLM)
Motor TTS lleuger amb veu catalana
Veu catalana?
No específica (Qwen3-TTS, general)
Sí: Ona (ca_ES-upc_ona-medium, UPC)
Instal·lació
Python venv a ~/tts-server
Docker
Estat actual
Aturat
En marxa ✅
Per què vam afegir el Piper (10200)?
Perquè volies una veu catalana de qualitat (l’Ona de la UPC). El Piper és:
Lleuger i offline — perfecte per a un punt de treball local
Té el model ca_ES-upc_ona-medium específic per a català
S’integra amb Speech Dispatcher perquè el sistema llegeixi text en català
Docker el fa fàcil d’instal·lar, actualitzar i reinstal·lar
I el 8765?
No l’hem tret! El speech-to-speech continua instal·lat a ~/tts-server, només està aturat (ho vam veure quan ss no mostrava res al port 8765). És un servidor més «complet» (xat de veu amb micròfon + LLM), però no té la veu catalana específica.
Resum: el 8765 és per al xat de veu general, i el 10200 és el que et dona l’Ona en català. Cadascú al seu port, sense conflictes! 😊
SERVIDOR TTS SERVER /home/Miquel/tts-server
Què hi ha a ~/tts-server (sí, tot el servei speech-to-speech)
/home/Miquel/tts-server/
├── venv/                    ← entorn Python amb el paquet speech-to-speech
├── prova_piper.py           ← els nostres scripts de prova
├── prova_piper_dbg.py
└── ...
Aquí hi ha tot el servei speech-to-speech (el del port 8765): l’entorn virtual, el paquet instal·lat i els scripts.
On és la veu de l’Ona? (⚠️ NO és aquí)
La veu Ona NO està a ~/tts-server — està dins del contenidor Docker piper, a la carpeta /config/:
# Per veure-ho:
docker exec piper ls -lh /config/
Hi trobaràs:
ca_ES-upc_ona-medium.onnx       ← el model de veu
ca_ES-upc_ona-medium.onnx.json  ← config de la veu
⚠️ Punt important
Com que al docker runno vam muntar cap volum (-v), la veu viu dins de la capa del contenidor. Si algun dia fas docker rm -f piper, la veu es perd i es tornarà a descarregar en recrear el contenidor (caldrà internet la primera vegada).
Resum:
speech-to-speech → tot a ~/tts-server ✅
Ona → dins del contenidor Docker piper a /config/ ✅
Si vols preservar la veu encara que esborris el contenidor, et puc explicar com muntar un volum per a /config. T’interessa? 😊
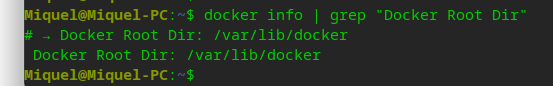
Docker no penja de cap carpeta del teu usuari — el seu directori d’emmagatzematge és a nivell de sistema: /var/lib/docker
📁 Directori arrel de Docker /var/lib/docker
/var/lib/docker/
├── containers/    ← dades dels contenidors
├── image/         ← imatges (linuxserver/piper, etc.)
├── overlay2/      ← capes del sistema de fitxers dels contenidors
├── volumes/       ← volums (si n'hi ha)
└── ...
# Backup
tar czf tts-server-backup.tar.gz -C /home/Miquel tts-server

# Restauració (al mateix camí /home/Miquel/tts-server)
tar xzf tts-server-backup.tar.gz -C /home/Miquel
⚠️ Detall important: l’entorn virtual (venv) guarda camins absoluts. Si restaures al mateix camí (/home/Miquel/tts-server), funciona tal qual. Si el camí canvia, caldria recrear el venv i reinstal·lar el paquet.
2️⃣ Piper + veu Ona (port 10200) → Docker
Aquí tens dues opcions:
Opció A — Recomanada (lleugera): fer backup de la imatge + la carpeta de config
# Backup de la imatge Docker (el programa)
docker save linuxserver/piper -o piper-image.tar

# La veu: si muntem el volum /config (com et vaig suggerir), es desa a ~/piper-config
tar czf piper-config-backup.tar.gz ~/piper-config
Opció B — Completa (tot Docker): backup de /var/lib/docker
# Requereix sudo i és més pesat
sudo tar czf docker-full-backup.tar.gz /var/lib/docker
✅ El teu plantejament, confirmat PODEM FER BACKUP DEL SERVIDORS TTS
Servei
On es desa
Com es recupera
speech-to-speech (8765)
~/tts-server
Copiar la carpeta enrere
Piper + Ona (10200)
/var/lib/docker (imatge + capa contenidor)
Restaurar Docker odocker save + volum /config
Resum: sí, amb un backup de ~/tts-server + Docker ho recuperes tot. Però la manera més neta és:
tar de ~/tts-server (per al 8765)
docker save de la imatge + volum /config (per al 10200 i l’Ona) — així no cal tocar tot /var/lib/docker
Vols que et prepari un script de backup/restauració senzill amb tot això? 😊
Endavant! Et preparo dos scripts: un de backup i un de restauració. Els pots desar on vulguis (per exemple a ~/).
📦 Script 1 — Backup (tts_backup.sh)
Desa’l amb aquesta comanda:
# Amb l'USB "backup_tot" connectat, només cal:
~/tts_backup.sh
# → USB 'backup_tot' trobat a: /media/Miquel/backup_tot
# → Desant a: /media/Miquel/backup_tot/20260913_...

# Si l'USB no està connectat, et dirà que el connectis
Sí! Podem fer que el script busqui automàticament l’USB amb l’etiqueta backup_tot. Desa aquesta versió:
cat > ~/tts_backup.sh << 'EOF'
#!/bin/bash
# ============================================
# Backup del sistema TTS local (Deepin)
# Us: ./tts_backup.sh [carpeta_destinacio]
#   Sense arguments: busca automaticament l'USB "backup_tot"
#   Exemple: ./tts_backup.sh /media/Miquel/backup_tot
# ============================================
set -e

USB_LABEL="backup_tot"
DEST=""

# 1) Si es passa una carpeta, s'usa aquesta
if [ -n "$1" ]; then
  DEST="$1"
else
  # 2) Si no, buscar l'USB amb l'etiqueta backup_tot
  DEST=$(findmnt -rn -o TARGET -S LABEL="$USB_LABEL" 2>/dev/null | head -1)
  if [ -z "$DEST" ]; then
    DEST=$(ls -d /media/*/"$USB_LABEL" /run/media/*/"$USB_LABEL" 2>/dev/null | head -1)
  fi
  if [ -n "$DEST" ]; then
    echo "USB '$USB_LABEL' trobat a: $DEST"
  fi
fi

# Si no s'ha trobat cap destinacio, error
if [ -z "$DEST" ]; then
  echo "ERROR: no s'ha trobat la destinacio."
  echo "  - Connecta l'USB '$USB_LABEL' i munta'l"
  echo "  - O indica una carpeta: $0 /ruta/destinacio"
  exit 1
fi

# Comprovar permisos
if [ ! -d "$DEST" ] || [ ! -w "$DEST" ]; then
  echo "ERROR: la destinacio '$DEST' no existeix o no es pot escriure."
  exit 1
fi

DATA=$(date +%Y%m%d_%H%M%S)
BACKUP_DIR="$DEST/$DATA"
mkdir -p "$BACKUP_DIR"
echo "Desant a: $BACKUP_DIR"

echo "=== 1/3 Backup de ~/tts-server (speech-to-speech) ==="
if [ -d "$HOME/tts-server" ]; then
  tar czf "$BACKUP_DIR/tts-server.tar.gz" -C "$HOME" tts-server
  echo "OK -> tts-server.tar.gz"
else
  echo "AVIS: ~/tts-server no existeix, s'omet."
fi

echo "=== 2/3 Backup de la imatge Docker linuxserver/piper ==="
if docker image inspect linuxserver/piper >/dev/null 2>&1; then
  docker save linuxserver/piper -o "$BACKUP_DIR/piper-image.tar"
  echo "OK -> piper-image.tar"
else
  echo "AVIS: imatge linuxserver/piper no trobada, s'omet."
fi

echo "=== 3/3 Backup de la veu Ona (/config del contenidor piper) ==="
if docker ps -a --format '{{.Names}}' | grep -qx piper; then
  mkdir -p "$BACKUP_DIR/piper-config"
  docker cp piper:/config/. "$BACKUP_DIR/piper-config/"
  echo "OK -> piper-config/"
else
  echo "AVIS: contenidor piper no existeix, s'omet."
fi

echo ""
echo "=== RESUM ==="
du -sh "$BACKUP_DIR"/*
echo "Backup completat a: $BACKUP_DIR"
EOF
chmod +x ~/tts_backup.sh
🚀 Com funciona ara
# Amb l'USB "backup_tot" connectat, només cal:
~/tts_backup.sh
# → USB 'backup_tot' trobat a: /media/Miquel/backup_tot
# → Desant a: /media/Miquel/backup_tot/20260913_...

# Si l'USB no està connectat, et dirà que el connectis
Com ho detecta:
Primer prova findmnt -S LABEL=backup_tot (busca per etiqueta a tots els punts de muntatge)
Si no, busca a les rutes típiques /media/*/backup_tot i /run/media/*/backup_tot
Encara pots forçar una ruta manual si vols: ~/tts_backup.sh /altre/lloc
⚠️ Recorda: l’USB ha d’estar connectat i muntat abans d’executar el script. Vols provar-ho? 😊
♻️ Script 2 — Restauració (tts_restore.sh)
cat > ~/tts_restore.sh << 'EOF'
#!/bin/bash
# ============================================
# Restauració del sistema TTS local (Deepin)
# Us: ./tts_restore.sh <directori_backup>
# ============================================
set -e

if [ -z "$1" ]; then
  echo "Us: $0 <directori_backup>"
  echo "Exemple: $0 ~/tts-backups/20260913_120000"
  exit 1
fi
BACKUP_DIR="$1"

echo "=== 1/3 Restauracio de ~/tts-server ==="
if [ -f "$BACKUP_DIR/tts-server.tar.gz" ]; then
  tar xzf "$BACKUP_DIR/tts-server.tar.gz" -C "$HOME"
  echo "OK: tts-server restaurat"
else
  echo "AVIS: no hi ha tts-server.tar.gz"
fi

echo "=== 2/3 Restauracio de la imatge Docker ==="
if [ -f "$BACKUP_DIR/piper-image.tar" ]; then
  docker load -i "$BACKUP_DIR/piper-image.tar"
  echo "OK: imatge carregada"
else
  echo "AVIS: no hi ha piper-image.tar"
fi

echo "=== 3/3 Recreacio del contenidor piper i restauracio de la veu ==="
if docker ps -a --format '{{.Names}}' | grep -qx piper; then
  echo "El contenidor piper ja existeix; l'elimino per recrear-lo."
  docker rm -f piper
fi

docker create --name piper \
  -p 10200:10200 \
  -e PIPER_VOICE=ca_ES-upc_ona-medium \
  --restart unless-stopped \
  linuxserver/piper

if [ -d "$BACKUP_DIR/piper-config" ]; then
  docker cp "$BACKUP_DIR/piper-config/." piper:/config/
  echo "OK: veu Ona restaurada a /config"
else
  echo "AVIS: no hi ha piper-config; el contenidor descarregara la veu de nou."
fi

docker start piper

echo ""
echo "=== VERIFICACIO ==="
docker ps | grep piper || true
echo "Restauracio completada."
EOF
chmod +x ~/tts_restore.sh
🚀 Com s’utilitzen
# 1. Fer un backup (es desa a ~/tts-backups/AMB_DATA)
~/tts_backup.sh

# 2. Veure els backups disponibles
ls -lh ~/tts-backups/

# 3. Restaurar (indicant el directori del backup)
~/tts_restore.sh ~/tts-backups/20260913_120000
Avís: la restauració elimina i recrea el contenidor piper si ja existeix (la veu es recupera des del backup, sense necessitat de descarregar-la).
Vols que t’obri el terminal per crear els scripts i provar el backup? 😊