GUIA TTS — Prova, Llançament i Reinstal·lació

Perfecte! 😄 Doncs aquí tens la versió neta i apta per al blog (sense decoracions de xat), llesta per copiar i enganxar:


GUIA TTS — Prova, Llançament i Reinstal·lació

1) Provar si el servidor escolta pel port

Servidor speech-to-speech (port 8765):

ss -tlnp | grep 8765
curl -s http://127.0.0.1:8765/v1/models

Servidor Piper (Docker, port 10200):

docker ps | grep piper
printf '{"type":"describe"}\n\n' | timeout 3 nc 127.0.0.1 10200

Prova completa de síntesi amb l’Ona: el script prova_piper.py (a ~/tts-server/) genera prova_ona.wav.

2) Com llançar-lo

speech-to-speech (port 8765):

cd ~/tts-server && source venv/bin/activate
export OPENAI_API_KEY="la-teva-clau"   # opcional, només si fas servir LLM en línia
speech-to-speech

Piper (port 10200):

docker start piper

O bé, si el contenidor no existeix:

docker run -d --name piper -p 10200:10200 -e PIPER_VOICE=ca_ES-upc_ona-medium --restart unless-stopped linuxserver/piper

3) Desinstal·lar-ho tot i tornar a instal·lar

Piper (Docker):

docker rm -f piper
docker image rm linuxserver/piper

docker run -d --name piper -p 10200:10200 -e PIPER_VOICE=ca_ES-upc_ona-medium --restart unless-stopped linuxserver/piper

speech-to-speech (port 8765):

rm -rf ~/tts-server

mkdir -p ~/tts-server && cd ~/tts-server
python3 -m venv venv
source venv/bin/activate
pip install --upgrade pip
pip install speech-to-speech

4) Al nou punt de treball (amb so)

  1. Comprova el so del sistema: speaker-test -t wav -l 1
  2. Aixeca el Piper: docker start piper (amb –restart unless-stopped s’aixecarà sol)
  3. Prova el port 10200 amb prova_piper.py i escolta prova_ona.wav

Que vagi bé amb el blog! 📝 Si després vols que et prepari una explicació més llarga o amb captures per a l’entrada, m’ho dius!

Integració de Speech Dispatcher amb Piper TTS (veu Ona, UPC) a Deepin

Data: 12 de setembre de 2026 — Estat actual del projecte

🎯 Objectiu

Aconseguir que Firefox pugui llegir pàgines web en català amb la veu Ona (UPC) mitjançant la cadena:

Firefox → Speech Dispatcher → mòdul genèric (sd_generic) → script pont → Piper (Docker) → Veu Ona

El repte: Speech Dispatcher no detecta cap veu per defecte (0 veus), perquè Piper no és un motor TTS natiu de Speech Dispatcher.


🏗️ Arquitectura de la solució

ComponentPaper
FirefoxClient que demana síntesi de veu a Speech Dispatcher
Speech DispatcherDaemon intermediari (0.11.5)
sd_genericMòdul genèric de Speech Dispatcher que executa ordres externes
piper-spdScript pont: rep text, truca a Docker, retorna WAV
Piper (Docker)Motor TTS al port 10200 (protocol Wyoming)
Veu ca_ES-upc_ona-mediumVeu catalana d’Ona, desenvolupada a la UPC

📂 Fitxers creats

1. Script pont /usr/local/bin/piper-spd

Rep el text de Speech Dispatcher, el passa al contenidor Piper i genera el fitxer WAV:

#!/bin/bash
# piper-spd: pont entre Speech Dispatcher i Piper TTS (veus UPC)
MODEL="/config/ca_ES-upc_ona-medium.onnx"
OUTPUT=""
TEXT=""
VOICE="${VOICE:-ona}"

while [ $# -gt 0 ]; do
  case "$1" in
    -o) OUTPUT="$2"; shift 2;;
    -l|--list)
      echo "ona ca_ES medium"
      echo "pau ca_ES medium"
      exit 0;;
    -*) shift;;
    *) TEXT="$TEXT $1"; shift;;
  esac
done

[ -z "$OUTPUT" ] && { echo "Error: falta -o FITXER" >&2; exit 1; }

case "$VOICE" in
  pau) MODEL="/config/ca_ES-upc_pau-medium.onnx";;
  *)   MODEL="/config/ca_ES-upc_ona-medium.onnx";;
esac

if ! docker ps --format '{{.Names}}' | grep -q '^piper$'; then
  echo "Error: el contenidor piper no està en marxa" >&2
  exit 1
fi

docker exec piper bash -c "printf '%s' \"$TEXT\" | piper --model $MODEL --output_file /tmp/piper_spd.wav" 2>/dev/null
if ! docker cp piper:/tmp/piper_spd.wav "$OUTPUT" 2>/dev/null; then
  echo "Error: no s'ha pogut generar l'àudio" >&2
  exit 1
fi
docker exec piper rm -f /tmp/piper_spd.wav 2>/dev/null
exit 0

2. Configuració del mòdul /etc/speech-dispatcher/modules/piper-generic.conf

GenericExecuteSynth "VOICE=$VOICE /usr/local/bin/piper-spd -o $FILE $TEXT"
GenericSsmlMode "off"
GenericLanguage "ca" "ca"

AddVoice "ca" "FEMALE1" "ona"
defaultVoice "ona"

3. Registre a /etc/speech-dispatcher/speechd.conf

AddModule "piper" "sd_generic" "/etc/speech-dispatcher/modules/piper-generic.conf"

🧗 Obstacles superats (i com es van resoldre)

  1. Mòdul sd_generic no localitzable → Resulta que es troba a /usr/lib/speech-dispatcher-modules/ (sense subdirectori intermedi).
  2. Speech Dispatcher es negava a arrencar → El directori de depuració /tmp/speechd-debug bloquejava l’inici; cal esborrar-lo abans d’arrencar.
  3. Error --voice is required for the piper backend (Docker) → Calia especificar PIPER_VOICE=ca_ES-upc_ona-medium en crear el contenidor.
  4. aplay dins del contenidor no funcionava → La síntesi es fa al contenidor i la reproducció a l’amfitrió.
  5. Error «The module does not have any voice configured» → Faltava la secció AddVoice a la configuració del mòdul genèric. Aquest era el pas definitiu! ✅

✅ Estat actual

  • Docker instal·lat i operatiu a Deepin
  • Piper TTS funcionant al port 10200 amb la veu Ona
  • Speech Dispatcher arrenca amb el mòdul piper registrat
  • Script pont validat (genera WAV de ~90 kB correctament)
  • Veus definides al mòdul (AddVoice "ca" "FEMALE1" "ona")
  • Prova final d’àudio pendent en un equip amb sortida de so
  • Prova a Firefox pendent (mode lectura → «Llegir en veu alta»)

🔧 Proves de verificació

# 1. Mòduls de sortida (ha d'aparèixer "piper")
spd-say -O

# 2. Veus disponibles
spd-say -o piper -L

# 3. Síntesi amb l'Ona
spd-say -o piper "Hola, soc l'Ona, la meva veu s'ha desenvolupat a la UPC de Barcelona"

🔄 Guia de reproducció (en un altre punt de treball)

  1. Instal·lar Docker i engegar el contenidor Piper: podem primer eliminar piper

docker rm -f piper

docker run -d --name piper -p 10200:10200 -e PIPER_VOICE=ca_ES-upc_ona-medium --restart unless-stopped linuxserver/piper
  1. Instal·lar Speech Dispatcher:sudo apt install speech-dispatcher -y
  2. Crear els 2 fitxers i modificar linia de /etc/speech-dispatcher/speechd.conf.
#	el fitxers estan descrits més amunt
#       Acció	       Fitxer
1	Crear script	sudo nano /usr/local/bin/piper-spd
2	Crear config del mòdul	sudo nano /etc/speech-dispatcher/modules/piper.conf
3	Afegir línia AddModule "piper" "sd_generic" "piper-spd"	/etc/speech-dispatcher/speechd.conf ⬅️ (no al piper.conf)

  1. Reiniciar:
rm -rf /tmp/speechd-debug
pkill -9 -f speech-dispatcher
sleep 1
speech-dispatcher
  1. Provar amb les ordres de verificació.

spd-say -o piper -y ca_ES-upc_ona-medium "Hola, sóc l'Ona, la veu del Piper."

🚀 Properes passes

  • Baixar la veu pau (masculina, UPC) i afegir AddVoice "ca" "MALE1" "pau" al mòdul.
  • Prova final a un equip amb àudio i validació a Firefox (mode lectura).
  • Automatització de l’arrencada de Speech Dispatcher a l’inici de sessió.
  • Portabilitat al Synology (192.168.1.49) replicant el contenidor Piper.

🎓 Conclusions

  • La integració de Piper amb Speech Dispatcher és possible mitjançant el mòdul genèric (sd_generic) amb un script pont, sense necessitat de compilar cap extensió nativa.
  • El punt crític va ser la definició de veus (AddVoice) — sense ella, el mòdul no pot inicialitzar-se.
  • El resultat permetrà que qualsevol aplicació que parli amb Speech Dispatcher (Firefox, ORCA, etc.) faci servir la veu Ona en català.
  • L’ús de Docker garanteix la portabilitat entre equips i plataformes (inclòs Synology).

Crèdits: projecte realitzat amb assistència de UOS AI sobre Deepin Desktop Environment.


Espero que et sigui útil al blog! Si quan el reprodueixis al punt de treball amb so veus algun detall a afinar (qualitat, volum, etc.), ho ajustem. Bona sort amb la reproducció! 🎙️😊

 ⭐⭐⭐Muntatge d’un servidor TTS local amb veu catalana (Ona, UPC) a Deepin

proposta millorada de qween

🎯 Objectius

L’objectiu del projecte es doble:

  1. Instal·lar un servidor local de síntesi de veu (TTS) accessible a http://127.0.0.1:8765/, amb capacitat de conversa (STT + LLM + TTS).
  2. Disposar d’una veu en català d’alta qualitat per a proves i integració, de manera que el sistema es pugui reproduir en altres punts de treball amb audio.

El resultat final combina dues eines complementàries:

  • speech-to-speech (servidor conversacional complet, port 8765)
  • Piper TTS amb la veu Ona de la UPC (port 10200)

docker exec piper bash -c "echo 'Hola bon dia.' | piper --model /config/ca_ES-upc_ona-medium.onnx --output-raw" | aplay -f S16_LE -r 22050 -c 1


Tens totalment raó! 😅 Hi ha DOS protocols diferents segons el servei:


🔄 ELS DOS PROTOCOLS

1. Speech-to-Speech (Port 8765)

  • Protocol: ✅ HTTP/WebSocket
  • URL: http://127.0.0.1:8765/
  • Aquest és el servidor conversacional complet (STT + LLM + TTS)
  • Es pot consultar via HTTP normal

2. Piper TTS (Port 10200)

  • Protocol: ✅ Wyoming Protocol
  • Port: 10200
  • Aquest és el Piper pur (només TTS)
  • NO és HTTP REST (per això curl no funciona)
  • Dissenyat per a Home Assistant

📝 Resum clar:

ServeiPortProtocolComanda
Speech-to-Speech8765HTTP/WebSocketcurl http://127.0.0.1:8765/ ✅
Piper TTS10200Wyomingcurl http://127.0.0.1:10200/ ❌ (Empty reply)

🎯 Per a Piper (Wyoming), utilitza:

# Via Docker exec (el que hem provat)
docker exec piper bash -c "echo 'text' | piper --model ... --output-raw" | aplay ...

# O via Wyoming Protocol (més complex, per a Home Assistant)
docker exec piper bash -c "echo 'Hola bon dia.' | piper --model /config/ca_ES-upc_ona-medium.onnx --output-raw" | aplay -f S16_LE -r 22050 -c 1

Gràcies per l’aclariment! Així queda molt més clar. 👍


📦 Fase 1 — Preparació de l’entorn

Sistema: Deepin (basat en Debian)

sudo apt update
sudo apt install python3 python3-pip python3-venv git docker.io -y

Creació de l’entorn virtual i instal·lació del paquet conversacional:

mkdir -p ~/tts-server && cd ~/tts-server
python3 -m venv venv
source venv/bin/activate
pip install --upgrade pip
pip install speech-to-speech

🚀 Fase 2 — Primer arrencada del servidor speech-to-speech

speech-to-speech

Resultats de la primera execució:

  • ✅ Descarrega automàtica de dependències (NLTK, Silero VAD)
  • ✅ Descarrega del model de reconeixement de veu Parakeet TDT (nvidia/parakeet-tdt-0.6b-v3, ~230 MB)
  • ✅ Model desat en memòria cau (~/.cache/huggingface)

Incidents detectats:

  • ⚠️ Mòdul opcional DeepFilterNet no disponible (millora d’àudio, no crític)
  • ⚠️ Avís de HF_TOKEN (només per a límits de descàrrega, no impedeix el funcionament)

Observació important: el servidor escolta en protocol WebSocket a ws://127.0.0.1:8765/v1/realtime, no és un endpoint HTTP clàssic, per tant curl no és el client adequat per provar-lo.


🐳 Fase 3 — Instal·lació de Docker a Deepin

Per al desplegament lleuger del TTS, vam instal·lar Docker:

sudo systemctl enable --now docker
sudo usermod -aG docker $USER
newgrp docker   # activa el grup a la sessió actual

Prova de verificació:

docker run hello-world

✅ Resposta: «Hello from Docker!» → instal·lació correcta.


🗣️ Fase 4 — Piper TTS amb veu catalana (Ona, UPC)

Creació del contenidor amb la veu catalana:

docker run -d \
  --name piper \
  -p 10200:10200 \
  -e PIPER_VOICE=ca_ES-upc_ona-medium \
  --restart unless-stopped \
  linuxserver/piper

Incident resolt: a la primera creació sense PIPER_VOICE, el contenidor fallava amb l’error --voice is required for the piper backend. Calia especificar la veu mitjançant la variable d’entorn.

Logs d’èxit:

INFO:wyoming_piper.download:Downloaded /config/ca_ES-upc_ona-medium.onnx
INFO:__main__:Ready
Connection to localhost (127.0.0.1) 10200 port [tcp/*] succeeded!

✅ Veu Ona (ca_ES-upc_ona-medium, desenvolupada a la UPC de Barcelona) descarregada i carregada.


🔊 Fase 5 — Prova de síntesi de veu

Síntesi directa dins del contenidor:

docker exec piper bash -c "echo 'Hola, soc l'Ona, la meva veu s'ha desenvolupat a la UPC de Barcelona.' | piper --model /config/ca_ES-upc_ona-medium.onnx --output_file /config/prova.wav"

Extracció i reproducció:

docker cp piper:/config/prova.wav ~/prova.wav
aplay ~/prova.wav

Per fer que l’àudio soni directament pels altaveus en lloc de guardar-lo en un fitxer,

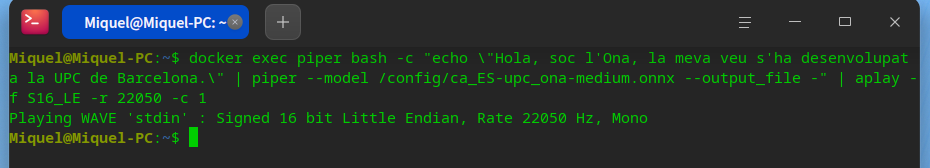
docker exec piper bash -c "echo \"Hola, soc l'Ona, la meva veu s'ha desenvolupat a la UPC de Barcelona.\" | piper --model /config/ca_ES-upc_ona-medium.onnx --output_file -" | aplay -f S16_LE -r 22050 -c 1

Despres d’un canvi de sessió o inicialització pot arrancar així:

Aquí tens la comanda modificada utilitzant aplay (el reproductor estàndard d’ALSA a Linux):


✅ Fitxer WAV generat correctament: 220 kB, 22.050 Hz, 16 bits, mono
⚠️ La reproducció d’àudio no es va poder verificar en aquest equip per manca de sortida d’àudio.


📊 Resultats finals

ServeiPortProtocolEstat
speech-to-speech (STT+LLM+TTS)8765WebSocket (/v1/realtime)✅ Instal·lat (models en cau)
Piper TTS (veu Ona, català)10200Wyoming✅ Funcionant
Docker——✅ Operatiu

Arxius i ubicacions clau:

  • Entorn virtual: ~/tts-server/venv
  • Cau de models HuggingFace: ~/.cache/huggingface
  • Model de veu: /config/ca_ES-upc_ona-medium.onnx (dins del contenidor)
  • Àudio de prova: ~/prova.wav

🔄 Fases de reproducció en un altre punt de treball

  1. Instal·lar dependències: python3-venv, git, docker.io
  2. Crear l’entorn virtual i instal·lar speech-to-speech
  3. Arrencar el servidor conversacional: speech-to-speech (port 8765)
  4. Instal·lar Docker i afegir l’usuari al grup
  5. Crear el contenidor Piper amb PIPER_VOICE=ca_ES-upc_ona-medium (port 10200)
  6. Verificar amb els logs: missatge Ready i connexió al port 10200
  7. Prova de síntesi: docker exec piper ... | piper --model ... --output_file ...

🚀 Properes passes (ampliació prevista)

  • Desplegament al Synology (192.168.1.49) mitjançant el Centre de paquets → Container Manager, replicant el contenidor Piper al port 10200.
  • Integració amb Home Assistant (protocol Wyoming compatible).
  • Prova d’àudio a un equip amb sortida d’àudio per validar la qualitat de la veu.
  • Exploració d’altres veus del catàleg de Piper (ca_ES-upc_pau-medium, masculina).

Depèn de què vulguis fer exactament:

🔁 Opció 1: Tancar sessió gràficament (Deepin)

  1. Fes clic a la icona d’engegada/apagada (a la safata del sistema, a la part inferior dreta de la pantalla, o a l’extrem superior dret).
  2. Selecciona «Tanca la sessió» (o Log Out).
  3. A la pantalla d’inici de sessió, selecciona el teu usuari i escriu la contrasenya.

💡 També pots fer servir la drecera de teclat Ctrl + Alt + Del (en algunes versions obre el menú amb l’opció de tancar sessió).


🔄 Opció 2: Simplement reiniciar l’ordinador

Si et surt més a compte:

sudo reboot

✅ Què passa quan tornis a entrar?

ServeiEs reinicia sol?
Docker✅ Sí (servei del sistema)
Contenidor Piper✅ Sí (té --restart unless-stopped)
Servidor speech-to-speech (port 8765)❌ No — l’has d’engegar manualment

Per engegar el servidor conversacional després de reiniciar:

cd ~/tts-server && source venv/bin/activate && speech-to-speech

🧪 Verifica que tot va bé després d’entrar

# Docker i el teu grup
groups | grep docker

# El contenidor Piper en marxa
docker ps | grep piper

Si surt docker a la primera comanda i el contenidor piper apareix com a Up, tot està correcte! ✅

Vols que et creï un script d’inici automàtic perquè el servidor de 8765 també s’engegui sol en entrar a la sessió? 😊


🎓 Conclusions

  • La instal·lació d’un TTS en català és viable amb eines de codi obert (Piper + veus de la UPC), sense necessitat de serveis externs.
  • La combinació speech-to-speech + Piper cobreix tant el cas d’ús conversacional complet (WebSocket 8765) com el de síntesi lleugera i fiable (Wyoming 10200).
  • L’ús de Docker garanteix la portabilitat i la reproductibilitat entre equips i fins i tot en NAS com el Synology.
  • La veu Ona de la UPC ofereix una síntesi en català de bona qualitat i és la candidata principal per al desplegament final.

Crèdits: projecte realitzat amb assistència de UOS AI sobre Deepin Desktop Environment.


Espero que et vagi molt bé al blog! 📖 Si vols, també et puc preparar una versió en Markdown més curta per a xarxes socials, o una guia PDF amb captures. Gràcies a tu per la paciència i bona feina! 😊

arrancar servidor deepin 127.0.0.1

🔧 Primer: engega el servidor

Pas 1 — Comprova si hi ha cap procés actiu

bash

ps aux | grep speech-to-speech | grep -v grep

2 líneas de código colapsadasExpandir

Si no surt res, el servidor està aturat.

Pas 2 — Engega’l (en segon pla, amb logs)

bash

cd ~/tts-server

source venv/bin/activate

nohup speech-to-speech > server.log 2>&1 &

4

4 líneas de código colapsadasExpandir

Pas 3 — Comprova que ha arrencat

bash

sleep 10 && ss -tlnp | grep 8765

2

2 líneas de código colapsadasExpandir

I mira els logs per veure si hi ha errors:

bash

tail -30 ~/tts-server/server.log

2

2 líneas de código colapsadasExpandir


📋 Explica’m què diu el log

Si el servidor no arrenca, el log et dirà per què (potser li falta baixar el model TTS gran, o hi ha un error de Python). Enganxa’m les últimes 20-30 línies de server.log i t’ho diagnostico.


🎯 Quan el servidor estigui en marxa, com es prova?

Com que és WebSocket, la prova correcta és amb un client WebSocket, no amb curl. Prova això en un altre terminal:

bash

1pip install websockets

2python3 -c «

3import asyncio, websockets

4async def t():

5 async with websockets.connect(‘ws://127.0.0.1:8765/v1/realtime’) as ws:

6 print(‘✅ Servidor TTS connectat!’)

7asyncio.run(t())

8″

9

9 líneas de código colapsadasExpandir

Comencem pel pas 1 i digue’m què surt! 👍

Enrutamiento Inteligente

Miquel@Miquel-PC:~$ tail -30 ~/tts-server/server.log nohup: no se tendrá en cuenta la entrada DeepFilterNet not available for audio enhancement: No module named ‘df’ [nltk_data] Downloading package averaged_perceptron_tagger_eng to [nltk_data] /home/Miquel/nltk_data… [nltk_data] Package averaged_perceptron_tagger_eng is already up-to- [nltk_data] date! Using cache found in /home/Miquel/.cache/torch/hub/snakers4_silero-vad_master /home/Miquel/tts-server/venv/lib/python3.12/site-packages/torch/jit/_serialization.py:176: FutureWarning: `torch.jit.load` is deprecated. Please switch to `torch.export`. warnings.warn( 2026-09-11 08:12:24,023 – speech_to_speech.STT.parakeet_tdt_handler – INFO – Loading Parakeet TDT model: nvidia/parakeet-tdt-0.6b-v3 on cpu 2026-09-11 08:12:24,231 – httpx – INFO – HTTP Request: HEAD https://huggingface.co/nvidia/parakeet-tdt-0.6b-v3/resolve/main/parakeet-tdt-0.6b-v3.nemo «HTTP/1.1 302 Found» Warning: You are sending unauthenticated requests to the HF Hub. Please set a HF_TOKEN to enable higher rate limits and faster downloads. 2026-09-11 08:12:24,232 – huggingface_hub.utils._http – WARNING – Warning: You are sending unauthenticated requests to the HF Hub. Please set a HF_TOKEN to enable higher rate limits and faster downloads. Miquel@Miquel-PC:~$

Deep think completado (tardó 4s)

El log revela el problema: el servidor s’ha quedat penjat just durant la descàrrega/verificació del model Parakeet TDT (l’última línia és el HEAD request a HuggingFace i després res).

🔍 Diagnòstic ràpid

Executa aquestes ordres per veure l’estat real:

1. El procés encara és viu?

bash

1ps aux | grep speech-to-speech | grep -v grep

2

2 líneas de código colapsadasExpandir

  • Si surt un procés → encara està descarregant (les barres de progrés no es veuen al log perquè nohup les bufferitza).
  • Si no surt res → s’ha mort silenciosament.

2. El model s’està descarregant?

bash

1du -sh ~/.cache/huggingface/hub/ 2>/dev/null

2

2 líneas de código colapsadasExpandir

Espera 10 segons i executa-la una altra vegada:

bash

1sleep 10 && du -sh ~/.cache/huggingface/hub/

2

2 líneas de código colapsadasExpandir

Si la mida augmenta → la descàrrega està en curs, només cal esperar. ⏳
Si la mida no canvia → la descàrrega s’ha aturat i cal reiniciar.


🛠️ Solució si s’ha aturat

Mata el procés mort i torna a engegar en primer pla per veure el progrés en directe:

bash

1pkill -f speech-to-speech

2cd ~/tts-server

3source venv/bin/activate

4speech-to-speech

5

5 líneas de código colapsadasExpandir

Així veuràs la barra de progrés de la descàrrega directament al terminal (sense buffer), i sabràs si avança o no.


💡 Si el model no es baixa bé: baixa’l manualment

Pots descarregar el model separat per assegurar-te que hi és:

bash

1cd ~/tts-server

2source venv/bin/activate

3python3 -c «

4from huggingface_hub import snapshot_download

5snapshot_download(‘nvidia/parakeet-tdt-0.6b-v3’)

6print(‘✅ Model STT descarregat!’)

7″

8

8 líneas de código colapsadasExpandir

Quan acabi, torna a executar speech-to-speech.


Fes el pas 1 i el pas 2 i digue’m què surt — així sabrem si està descarregant o si s’ha mort

Veu Ona al servidor local de deepin

curl -G --data-urlencode "text=Hola, això és una prova. Soc Ona aquesta veu s'ha desenvolupat  a la UPC de Barcelona" http://127.0.0.1:8765/

Pugin Ona server


aquesta genera un .wav al directori /temp

curl -sS -X POST \
  -H 'Content-Type: application/json' \
  -d "{\"text\":\"Hola, això és una prova. Soc Ona, aquesta veu s'ha desenvolupat a la UPC de Barcelona.\"}" \
  http://127.0.0.1:8765/synthesize \
  -o /tmp/ona.wav

Si volem que no generi .wav

curl -sS -X POST \
  -H 'Content-Type: application/json' \
  -d "{\"text\":\"Hola, això és una prova. Soc Ona, aquesta veu s'ha desenvolupat a la UPC de Barcelona.\"}" \
  http://127.0.0.1:8765/synthesize \
  | aplay

Reproduir amb ffplay (si vols més qualitat o control)

curl -sS -X POST \
  -H 'Content-Type: application/json' \
  -d "{\"text\":\"Hola, això és una prova. Soc Ona, aquesta veu s'ha desenvolupat a la UPC de Barcelona.\"}" \
  http://127.0.0.1:8765/synthesize \
  | ffplay -autoexit -

Perfecte! El port 8765 coincideix amb el projecte speech-to-speech, que aixeca un servidor local compatible amb OpenAI Realtime i inclou TTS (Qwen3-TTS) + STT (Parakeet TDT) + LLM. T’ajudo a instal·lar-lo a Deepin.

🔧 Requisits previs

Deepin és Debian-based, així que primer assegura’t de tenir Python i pip:

sudo apt update
sudo apt install python3 python3-pip python3-venv git -y

📦 Instal·lació del servidor TTS

Crea un entorn virtual i instal·la el paquet:

mkdir -p ~/tts-server && cd ~/tts-server
python3 -m venv venv
source venv/bin/activate
pip install --upgrade pip
pip install speech-to-speech

🚀 Posada en marxa

export OPENAI_API_KEY=...   # opcional, només si faràs servir un LLM en línia
speech-to-speech

Això aixecarà el servidor a ws://127.0.0.1:8765/v1/realtime amb la configuració per defecte:

  • 🎙️ STT local: Parakeet TDT
  • 🧠 LLM: compatible amb OpenAI (pots connectar-hi Ollama, LM Studio, etc.)
  • 🔊 TTS local: Qwen3-TTS

💻 Prova de conversa

En un altre terminal, executa:

cd ~/tts-server
source venv/bin/activate
python scripts/listen_and_play_realtime.py --host 127.0.0.1 --port 8765

🧠 Opció: LLM 100% local (sense claus API)

Si vols que tot sigui local, pots usar llama.cpp amb Gemma:

pip install llama-cpp-python
llama-server -hf ggml-org/gemma-4-... 

💡 Alternatives si només vols TTS pur (sense STT/LLM)

OpcióPortDescripció
Dia-TTS-Server5000git clone https://github.com/devnen/Dia-TTS-Server.git && pip install -r requirements.txt && python main.py
Piper (Docker)10200docker run -d --name piper -p 10200:10200 linuxserver/piper — molt lleuger, ideal per a NAS/rPi

Cap problema! Fem la comprovació pas a pas:

1️⃣ Primer, comprova si el servidor segueix en marxa

En un terminal nou, prova directament:

curl -v http://127.0.0.1:8765/v1/realtime 2>&1 | head -20

Si surt alguna resposta (fins i tot un error 400 o 426 Upgrade Required) → el servidor està funcionant i només cal un client per connectar-s’hi. 🎉

Si surt Could not connect → el servidor es va aturar (potser es va tancar el terminal o es va tallar la descàrrega).


2️⃣ Si el servidor es va aturar, torna a engegar-lo

cd ~/tts-server
source venv/bin/activate
speech-to-speech

💡 Bona notícia: els models que ja es van descarregar queden a la memòria cau (~/.cache/huggingface), així que aquesta vegada serà molt més ràpid — no tornarà a baixar res, només carregarà.


3️⃣ Alternativa: comprova si el port està escoltant

Mentre el servidor estigui en marxa, en un altre terminal:

ss -tlnp | grep 8765

Si surt una línia amb 0.0.0.0:8765 o 127.0.0.1:8765, el servidor està escoltant correctament. ✅


Fes el pas 1 i digue’m què surt — si és Could not connect, passa al pas 2 i enganxa’m el que mostri el servidor en arrencar! 😊

Confirmat: el servidor està aturat (el port 8765 no està escoltant). El que va passar és que probablement es va tancar el terminal on s’executava o es va interrompre.

🔄 Torna a engegar-lo (ara serà ràpid)

Com que els models ja estan a la memòria cau, no tornarà a baixar res:

cd ~/tts-server
source venv/bin/activate
speech-to-speech

Deixa aquest terminal obert i espera a veure el missatge que el servidor està escoltant.


💡 Consell: engega’l en segon pla (així no depens del terminal)

Si no vols tenir un terminal ocupat sempre, pots executar-lo en segon pla:

cd ~/tts-server
source venv/bin/activate
nohup speech-to-speech > server.log 2>&1 &

Després pots comprovar que funciona amb:

ss -tlnp | grep 8765

I veure els logs amb:

tail -f ~/tts-server/server.log

🔍 Si torna a no engegar, comprova els logs

Si després d’executar speech-to-speech no veus el missatge d’èxit, enganxa’m les últimes línies que surtin (o el contingut de server.log si fas servir el mètode del segon pla) i ho diagnostiquem. Pot ser que estigui intentant baixar el model TTS (que és gran, ~2-3 GB) i es tallés.

Què diu quan l’executes? 😊

Preparar USB Ventoy

Pas 1: Descarregar Ventoy

Pas 2: Preparar la USB
⚠️ Important: Aquest procés esborrarà totes les dades de la USB. Fes una còpia de seguretat si cal.

Pas 3: Instal·lar Ventoy (mètode de terminal)
Un cop descarregat i descomprimit el fitxer, obre el terminal i executa:

cd ~/Downloads/ventoy-*  # o la ruta on l'hagis descomprimit
sudo sh Ventoy2Disk.sh -i /dev/sdX

Canvia /dev/sdX pel teu dispositiu USB (pots veure’l amb lsblk).

Pas 4: Copiar la ISO
Després d’instal·lar Ventoy, la USB apareixerà com una partició normal. Només has d’arrossegar el fitxer ISO de Deepin 25 (o qualsevol altre) dins de la USB. No cal cap configuració extra: en arrencar des de la USB, Ventoy et mostrarà un menú per triar quina ISO carregar.


Com funciona Ventoy per particions:

  • Quan instal·les Ventoy, crea 2 particions automàticament:
    1. VTOYEFI (petita, ~32MB): la partició d’arrencada.
    2. exFAT (la resta de l’espai): aquí és on poses els fitxers ISO.
  • La partició exFAT és la que Ventoy llegeix per mostrar el menú d’ISOs a l’arrencar.

I el teu backup de fotos?
Sí que pots! Després d’instal·lar Ventoy, pots reduir la partició exFAT i crear-ne una de nova (per exemple EXT4, NTFS o exFAT) amb l’espai lliure. Aquesta partició extra:

  • Apareixerà com una unitat normal al sistema (com qualsevol disc dur extern).
  • No interferirà amb l’arrencada: Ventoy només llegeix la seva partició exFAT per buscar ISOs.
  • Podràs guardar les fotos, documents, etc., sense cap problema.

Com fer-ho a Deepin:

  1. Instal·la Ventoy a la USB (això esborrarà tot el disc).
  2. Obre l’aplicació «Gestor de discs» (o GParted).
  3. Redueix la partició exFAT per deixar espai lliure.
  4. Crea una partició nova amb aquest espai (NTFS o exFAT per compatibilitat amb Windows/macOS si ho necessites).
  5. Formateja-la i ja la pots fer servir per al backup de fotos.

💡 Consell: Quan arrenquis des de la USB, Ventoy només mostrarà les ISOs de la partició exFAT, així que les teves fotos estaran totalment «invisibles» durant l’arrencada, però accessibles quan arrenquis el sistema normal.

Piper TTS a Deepin

Comanda per dir bon dia amb la veu d’Ona:

echo "hola bon dia" | /home/Miquel/piper/piper -m /home/Miquel/piper_linux_x86_64/ca_ES-upc_ona-medium.onnx --output-raw | aplay -r 22050 -f S16_LE -t raw -

1. Extreure el fitxer correctament:

tar -xvf piper_linux_x86_64.tar.gz

2. Descarregar la veu en català (dins de la carpeta que acabes de crear):

wget -P piper_linux_x86_64 https://huggingface.co/rhasspy/piper-voices/resolve/main/ca/ca_ES/upc_ona/x_low/ca_ES-upc_ona-x_low.onnx
wget -P piper_linux_x86_64 https://huggingface.co/rhasspy/piper-voices/resolve/main/ca/ca_ES/upc_ona/x_low/ca_ES-upc_ona-x_low.onnx.json

3. Fer que l’ordinador parli:

echo "hola bon dia" | ./piper_linux_x86_64/piper -m ./piper_linux_x86_64/ca_ES-upc_ona-x_low.onnx --output-raw | aplay -r 22050 -f S16_LE -t raw -

📋 Xuleta d’Ús: Piper TTS (Català) a Deepin

1. COM usar-la des de la Terminal (Deepin)

Si vas afegir la funció al teu ~/.bashrc, tens dues eines ràpides:

  • Escoltar directament:parla "Hola Miquel, el sistema funciona perfectament."
  • Generar un fitxer d’àudio (sense reproduir-lo):cd ~/piper-tts/piper export LD_LIBRARY_PATH=. echo "Text a guardar" | ./piper --model ca_ES-upc_ona-medium.onnx --output_file /ruta/del/meu/fitxer.wav

2. COM usar-la des de PHP (Integració Web)

Com que treballes amb aplicacions PHP, pots generar àudio dinàmicament al servidor. Aquí tens un exemple segur i net:

<?php
$text = "Hola, això és una prova de veu generada des de PHP.";
$output_file = "/tmp/tts_" . uniqid() . ".wav";

// 1. Netejar el text per evitar injecció de comandes a la terminal
$text_net = escapeshellarg($text);

// 2. Construir la comanda (ajusta la ruta si el teu usuari no és 'Miquel')
$comanda = "cd /home/Miquel/piper-tts/piper && " .
           "export LD_LIBRARY_PATH=. && " .
           "echo $text_net | ./piper --model ca_ES-upc_ona-medium.onnx --output_file $output_file 2>/dev/null";

// 3. Executar
shell_exec($comanda);

// 4. Comprovar si s'ha creat i servir-lo (o retornar la ruta)
if (file_exists($output_file)) {
    header('Content-Type: audio/wav');
    header('Content-Disposition: attachment; filename="veu.wav"');
    readfile($output_file);
    unlink($output_file); // Neteja el fitxer temporal després d'enviar-lo
} else {
    echo "Error generant l'àudio.";
}
?>

Nota: Assegura’t que l’usuari que executa PHP (ex: www-data o el teu usuari en entorn de desenvolupament) tingui permisos d’execució a la carpeta /home/Miquel/piper-tts/piper.

3. ON i QUAN usar-la (Casos d’ús pràctics)

  • 🎓 Projectes d’aprenentatge d’idiomes: Com que t’interessa el suport multilingüe, pots canviar el model .onnx (ex: a en_US-amy-medium.onnx) per generar àudio d’exemple per a estudiants de català, anglès o basc.
  • ♿ Accessibilitat: Afegir un botó «Escoltar resposta» a les teves aplicacions web per a usuaris amb discapacitat visual o dificultats de lectura.
  • 🔔 Notificacions d’escriptori: Combinar-ho amb les notificacions de Deepin perquè l’ordinador et llegeixi alertes:parla "Atenció: la còpia de seguretat al servidor Synology ha finalitzat."
  • 🛠️ Depuració (Debugging): Fer que el servidor «parli» quan un script PHP llarg acaba d’executar-se, així no has d’estar mirant la pantalla constantment.

4. COM personalitzar la veu (Trucs avançats)

Piper permet ajustar paràmetres afegint-los a la comanda:

  • Fer-la parlar més ràpid: Afegeix --length_scale 0.8 (valors més baixos = més ràpid).
  • Fer-la parlar més a poc a poc: Afegeix --length_scale 1.2.
  • Més expressiva/aleatòria: Afegeix --noise_scale 0.8 (el valor per defecte és 0.66).

Exemple:

echo "Vaig molt ràpid!" | ./piper --model ca_ES-upc_ona-medium.onnx --length_scale 0.8 --output_file rapid.wav

5. RESOLUCIÓ RÀPIDA DE PROBLEMES

ProblemaSolució
Error: libpiper_phonemize.so.1: cannot openEstàs executant l’ordre fora de la carpeta o sense la variable d’entorn. Fes: cd ~/piper-tts/piper && export LD_LIBRARY_PATH=.
No se sent cap so amb paplayProva a reproduir el fitxer .wav directament amb el reproductor d’àudio del Deepin (doble clic). Si se sent, el problema és de configuració de PulseAudio/PipeWire, no de Piper.
La veu sona molt robòticaAssegura’t que estàs fent servir el model medium o high. Els models x_low són molt ràpids però sonen més artificials.

💡 Proper pas opcional

Si en el futur vols afegir una veu en anglès o basca al mateix sistema, només has de:

  1. Descarregar el .onnx i .json de la nova llengua des del repositori de veus de Piper.
  2. Posar-los a la carpeta ~/piper-tts/piper.
  3. Canviar --model ca_ES-upc_ona-medium.onnx pel nom del nou fitxer a les teves comandes o scripts PHP.

T’ha quedat clar amb aquest format? Si vols que adaptem la funció de bash o l’script de PHP per a algun cas concret dels teus projectes, digue-m’ho!

Backup sda4 → restauració a sda6

Sí. Et preparo una nota-resum tipus xuleta, centrada en què és backup_amd0_sda4_roota.img, quin és l’objectiu i els dos fluxos possibles: comprovar/recuperar i restaurar a sda6.

Backup sda4 → restauració a sda6

1. Punt de partida

Backup original:

/media/Miquel/backup_principal/backup_amd0_sda4_roota.img

Aquest fitxer NO és una imatge ext4 muntable directament.

És una imatge Partclone creada a partir de la partició:

/dev/sda4

La seva capçalera confirma:

partclone-image
0.3.27
EXTFS

Informació de la imatge:

Device size:   70,2 GB
Space in use:  23,0 GB
Free Space:    47,2 GB
Block size:    4096 bytes

Per tant:

sda4 (EXT4)
   │
   │ backup amb Partclone
   ▼
backup_amd0_sda4_roota.img

2. Objectiu

L’objectiu final és recuperar el sistema que hi havia a sda4 i posar-lo a sda6, sense tocar el backup original.

Abans de tocar sda6, volem comprovar que el backup és correcte.

Per això fem servir una imatge temporal.


3. Imatge temporal

Hem creat al mateix USB:

/media/Miquel/backup_principal/roota_temporal.img

Inicialment:

72 GiB

La vam preparar amb ext4, però això no és essencial, perquè Partclone substitueix el contingut durant la restauració.

El fitxer està associat actualment a:

/dev/loop0

És a dir:

/dev/loop0
      │
      ▼
roota_temporal.img

4. Flux de treball actual

Ara mateix està en curs:

                    LECTURA
                       │
                       ▼
backup_amd0_sda4_roota.img
       (Partclone EXTFS)
                       │
                       │ partclone.restore
                       ▼
                  /dev/loop0
                       │
                       ▼
              roota_temporal.img
                 (ext4 real)

La comanda utilitzada és:

sudo partclone.restore \
-s /media/Miquel/backup_principal/backup_amd0_sda4_roota.img \
-o /dev/loop0

Important

-s = source / origen

Per tant:

-s backup_amd0_sda4_roota.img

→ només llegeix el backup.

-o = output / destinació

-o /dev/loop0

→ escriu a roota_temporal.img.

No està escrivint ni a sda4 ni a sda6.


5. Quan Partclone arribi al 100 %

Primer comprovarem que la restauració ha acabat correctament.

Després muntarem:

roota_temporal.img
       │
       ▼
/mnt/backup_root

I podrem comprovar:

ls -lah /mnt/backup_root

i explorar el sistema recuperat.

També podrem comprovar que hi són directoris importants com:

/etc
/boot
/usr
/var
/home

segons l’estructura que tingués aquella instal·lació.


6. Flux final: restaurar a sda6

Si la còpia temporal és correcta, l’objectiu final serà:

backup original
       │
       ▼
roota_temporal.img
       │
       │ comprovat
       ▼
     /dev/sda6

És a dir:

           BACKUP
              │
              ▼
backup_amd0_sda4_roota.img
              │
              ▼
     roota_temporal.img
              │
              │ comprovació
              ▼
           /dev/sda6

sda4 no és la destinació final.


7. Regla de seguretat

Durant tot el procés:

backup_amd0_sda4_roota.img
        ↓
     ORIGINAL
        ↓
     NO TOCAR

No s’ha de fer mai:

partclone.restore ... -o /dev/sda4

ni:

partclone.restore ... -o /dev/sda6

fins que hàgim decidit definitivament que volem sobreescriure sda6.

Primer:

backup → temporal → comprovar → sda6


8. Estat actual

USB:

/dev/sdb1
227 GB total
87 GB utilitzats
129 GB lliures

Fitxers:

backup_amd0_sda4_roota.img    ← BACKUP ORIGINAL
roota_temporal.img             ← DESTINACIÓ TEMPORAL

Actualment:

Partclone → 11% ... en procés

Quan arribi al 100 %, no fem encara la restauració a sda6.

Primer comprovem la còpia temporal.

Així tenim el procediment ben documentat i, sobretot, queda clar el punt crític: sda4 és l’origen històric del backup, però sda6 serà la destinació final; roota_temporal.img és el pas intermedi de verificació.


La imatge backup_amd0_sda4_roota.img està en el format natiu de Partclone (no és una imatge dd en brut ni un fitxer comprimit). Et detallo:

Format de la imatge

  • Tipus: imatge de bloc de Partclone (partclone-image).
  • Contingut: només copia els blocs ocupats de la partició sda4 (la partició root), no tot l’espai en brut. Per això la imatge (≈23 GB) és més petita que la mida total de la partició.
  • Estructura interna: el fitxer .img conté una capçalera de Partclone + les dades de la partició, amb informació del sistema de fitxers (normalment ext4 en una arrel de sistema).

Com ho pots verificar

Per confirmar-ho al 100%, pots executar a la terminal:

file /media/Miquel/backup_principal/backup_amd0_sda4_roota.img

Hauries de veure una sortida similar a:

Clonezilla image (partclone), version 2.x

També pots obtenir informació detallada amb:

partclone.info -s /media/Miquel/backup_principal/backup_amd0_sda4_roota.img

Com restaurar-la

Com que és format Partclone (ext4), per recuperar-la hauries de fer:

sudo partclone.ext4 -r -s /media/Miquel/backup_principal/backup_amd0_sda4_roota.img -o /dev/sda4

Punt important

Aquesta imatge no es pot muntar directament (no és una imatge en brut tipus dd). Si el que vols és extreure un fitxer concret sense restaurar tota la partició, caldria primer convertir-la a una imatge en brut (per exemple amb partclone.restore -s ... -o image.raw) i després muntar-la amb mount -o loop.

Vols que t’ajudi amb algun d’aquests passos (verificar el format, restaurar-la o extreure un fitxer)?
Backup amb partclone

Backup amb partclone

Miquel@Miquel-PC:~$ lsblk

NAME MAJ:MIN RM SIZE RO TYPE MOUNTPOINTS

sda 8:0 0 476,9G 0 disk

├─sda1 8:1 0 100M 0 part /efi

├─sda2 8:2 0 16M 0 part

├─sda3 8:3 0 296,4G 0 part /media/Miquel/Windows

├─sda4 8:4 0 1,2G 0 part

├─sda5 8:5 0 129,3G 0 part /media/Miquel/Roota1

└─sda6 8:6 0 50G 0 part /var

/persistent/ostree

/ostree

/sysroot/ostree

/sysroot

/

sdb 8:16 1 231G 0 disk

└─sdb1 8:17 1 230,9G 0 part /media/Miquel/backup_principal1

Miquel@Miquel-PC:~$

se’n a sda6 vull ececutar aquesta comanda:

sudo partclone.ext4 -c -s /dev/sda5 -o /media/Miquel/

/media/Miquel/backup_principal1

1º desmuntar sda5

sudo umount /dev/sda5

├ ─sda5 8:5 0 129,3G 0 part

abans ├─sda5 8:5 0 129,3G 0 part /media/Miquel/Roota1

2º Instal·lar partclone (si encara no està instal·lat)

sudo apt update && sudo apt install partclone

3º executem comanda de backup

sudo partclone.ext4 -c -s /dev/sda5 -o /media/Miquel/backup_principal1/backup_amd1_sda5.img

4º Restauració

La partició no s’ha de dir igual — pot ser sda6, sdb1, sdc3… el nom depèn de com estigui organitzat el disc de l’altre ordinador. El que importa és que compleixi les condicions:

Condicions per a la partició de destinació (sigui la que sigui):

  1. Tamany ≥ al de la imatge (mai més petita).
  2. Format ext4 (igual que la imatge).
  3. Que no estigui muntada (o desmuntar-la abans).

Comanda de restaurauració adaptada per a l’exemple amb sda6:

sudo partclone.ext4 -r -s /media/Miquel/backup_principal/backup_amd1_sda5.img -o /dev/sda6

L’única diferència és el nom de la partició de destinació al final (/dev/sda6 en comptes de /dev/sda5). La imatge es restaura igual.

Passos recomanats a l’altre ordinador:

  1. Connecta el USB amb la imatge.
  2. Executa lsblk per veure quines particions hi ha i quina és la que vols (amb espai suficient i ext4).
  3. Assegura’t que no estigui muntada: sudo umount /dev/sda6 (si ho està).
  4. Llança la comanda amb la partició correcta.

I ja està! La imatge es restaura perfectament a qualsevol partició que compleixi els requisits. 😉