
🎯 Objectius
L’objectiu del projecte es doble:
- Instal·lar un servidor local de síntesi de veu (TTS) accessible a
http://127.0.0.1:8765/, amb capacitat de conversa (STT + LLM + TTS). - Disposar d’una veu en català d’alta qualitat per a proves i integració, de manera que el sistema es pugui reproduir en altres punts de treball amb audio.
El resultat final combina dues eines complementàries:
speech-to-speech(servidor conversacional complet, port 8765)- Piper TTS amb la veu Ona de la UPC (port 10200)
 docker exec piper bash -c "echo \"Hola, soc l'Ona, la meva veu s'ha desenvolupat a la UPC de Barcelona.\" | piper --model /config/ca_ES-upc_ona-medium.onnx --output_file -" | aplay -f S16_LE -r 22050 -c 1
Playing WAVE 'stdin' : Signed 16 bit Little Endian, Rate 22050 Hz, Mono
📦 Fase 1 — Preparació de l’entorn
Sistema: Deepin (basat en Debian)
sudo apt update
sudo apt install python3 python3-pip python3-venv git docker.io -y
Creació de l’entorn virtual i instal·lació del paquet conversacional:
mkdir -p ~/tts-server && cd ~/tts-server
python3 -m venv venv
source venv/bin/activate
pip install --upgrade pip
pip install speech-to-speech
🚀 Fase 2 — Primer arrencada del servidor speech-to-speech
speech-to-speech
Resultats de la primera execució:
- ✅ Descarrega automàtica de dependències (NLTK, Silero VAD)
- ✅ Descarrega del model de reconeixement de veu Parakeet TDT (nvidia/parakeet-tdt-0.6b-v3, ~230 MB)
- ✅ Model desat en memòria cau (
~/.cache/huggingface)
Incidents detectats:
- ⚠️ Mòdul opcional
DeepFilterNetno disponible (millora d’àudio, no crític) - ⚠️ Avís de
HF_TOKEN(només per a límits de descàrrega, no impedeix el funcionament)
Observació important: el servidor escolta en protocol WebSocket a ws://127.0.0.1:8765/v1/realtime, no és un endpoint HTTP clàssic, per tant curl no és el client adequat per provar-lo.
🐳 Fase 3 — Instal·lació de Docker a Deepin
Per al desplegament lleuger del TTS, vam instal·lar Docker:
sudo systemctl enable --now docker
sudo usermod -aG docker $USER
newgrp docker   # activa el grup a la sessió actual
Prova de verificació:
docker run hello-world
✅ Resposta: «Hello from Docker!» → instal·lació correcta.
🗣️ Fase 4 — Piper TTS amb veu catalana (Ona, UPC)
Creació del contenidor amb la veu catalana:
docker run -d \
  --name piper \
  -p 10200:10200 \
  -e PIPER_VOICE=ca_ES-upc_ona-medium \
  --restart unless-stopped \
  linuxserver/piper
Incident resolt: a la primera creació sense PIPER_VOICE, el contenidor fallava amb l’error --voice is required for the piper backend. Calia especificar la veu mitjançant la variable d’entorn.
Logs d’èxit:
INFO:wyoming_piper.download:Downloaded /config/ca_ES-upc_ona-medium.onnx
INFO:__main__:Ready
Connection to localhost (127.0.0.1) 10200 port [tcp/*] succeeded!
✅ Veu Ona (ca_ES-upc_ona-medium, desenvolupada a la UPC de Barcelona) descarregada i carregada.
🔊 Fase 5 — Prova de síntesi de veu
Síntesi directa dins del contenidor:
docker exec piper bash -c "echo 'Hola, soc l'Ona, la meva veu s'ha desenvolupat a la UPC de Barcelona.' | piper --model /config/ca_ES-upc_ona-medium.onnx --output_file /config/prova.wav"
Extracció i reproducció:
docker cp piper:/config/prova.wav ~/prova.wav
aplay ~/prova.wav
Per fer que l’àudio soni directament pels altaveus en lloc de guardar-lo en un fitxer,
docker exec piper bash -c "echo \"Hola, soc l'Ona, la meva veu s'ha desenvolupat a la UPC de Barcelona.\" | piper --model /config/ca_ES-upc_ona-medium.onnx --output_file -" | aplay -f S16_LE -r 22050 -c 1
Despres d’un canvi de sessió o inicialització pot arrancar així:
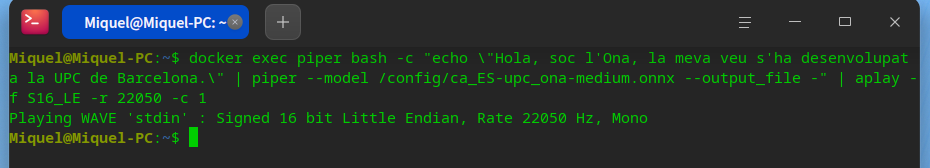
Aquí tens la comanda modificada utilitzant aplay (el reproductor estàndard d’ALSA a Linux):
✅ Fitxer WAV generat correctament: 220 kB, 22.050 Hz, 16 bits, mono
⚠️ La reproducció d’àudio no es va poder verificar en aquest equip per manca de sortida d’àudio.
📊 Resultats finals
| Servei | Port | Protocol | Estat |
|---|---|---|---|
| speech-to-speech (STT+LLM+TTS) | 8765 | WebSocket (/v1/realtime) | ✅ Instal·lat (models en cau) |
| Piper TTS (veu Ona, català) | 10200 | Wyoming | ✅ Funcionant |
| Docker | — | — | ✅ Operatiu |
Arxius i ubicacions clau:
- Entorn virtual:
~/tts-server/venv - Cau de models HuggingFace:
~/.cache/huggingface - Model de veu:
/config/ca_ES-upc_ona-medium.onnx(dins del contenidor) - Àudio de prova:
~/prova.wav
🔄 Fases de reproducció en un altre punt de treball
- Instal·lar dependències:
python3-venv,git,docker.io - Crear l’entorn virtual i instal·lar
speech-to-speech - Arrencar el servidor conversacional:
speech-to-speech(port 8765) - Instal·lar Docker i afegir l’usuari al grup
- Crear el contenidor Piper amb
PIPER_VOICE=ca_ES-upc_ona-medium(port 10200) - Verificar amb els logs: missatge
Readyi connexió al port 10200 - Prova de síntesi:
docker exec piper ... | piper --model ... --output_file ...
🚀 Properes passes (ampliació prevista)
- Desplegament al Synology (192.168.1.49) mitjançant el Centre de paquets → Container Manager, replicant el contenidor Piper al port 10200.
- Integració amb Home Assistant (protocol Wyoming compatible).
- Prova d’àudio a un equip amb sortida d’àudio per validar la qualitat de la veu.
- Exploració d’altres veus del catàleg de Piper (
ca_ES-upc_pau-medium, masculina).
Depèn de què vulguis fer exactament:
🔁 Opció 1: Tancar sessió gràficament (Deepin)
- Fes clic a la icona d’engegada/apagada (a la safata del sistema, a la part inferior dreta de la pantalla, o a l’extrem superior dret).
- Selecciona «Tanca la sessió» (o Log Out).
- A la pantalla d’inici de sessió, selecciona el teu usuari i escriu la contrasenya.
💡 També pots fer servir la drecera de teclat
Ctrl + Alt + Del(en algunes versions obre el menú amb l’opció de tancar sessió).
🔄 Opció 2: Simplement reiniciar l’ordinador
Si et surt més a compte:
sudo reboot
✅ Què passa quan tornis a entrar?
| Servei | Es reinicia sol? |
|---|---|
| Docker | ✅ Sí (servei del sistema) |
| Contenidor Piper | ✅ Sí (té --restart unless-stopped) |
| Servidor speech-to-speech (port 8765) | ❌ No — l’has d’engegar manualment |
Per engegar el servidor conversacional després de reiniciar:
cd ~/tts-server && source venv/bin/activate && speech-to-speech
🧪 Verifica que tot va bé després d’entrar
# Docker i el teu grup
groups | grep docker

# El contenidor Piper en marxa
docker ps | grep piper
Si surt docker a la primera comanda i el contenidor piper apareix com a Up, tot està correcte! ✅
Vols que et creï un script d’inici automàtic perquè el servidor de 8765 també s’engegui sol en entrar a la sessió? 😊
🎓 Conclusions
- La instal·lació d’un TTS en català és viable amb eines de codi obert (Piper + veus de la UPC), sense necessitat de serveis externs.
- La combinació
speech-to-speech+ Piper cobreix tant el cas d’ús conversacional complet (WebSocket 8765) com el de síntesi lleugera i fiable (Wyoming 10200). - L’ús de Docker garanteix la portabilitat i la reproductibilitat entre equips i fins i tot en NAS com el Synology.
- La veu Ona de la UPC ofereix una síntesi en català de bona qualitat i és la candidata principal per al desplegament final.
Crèdits: projecte realitzat amb assistència de UOS AI sobre Deepin Desktop Environment.
Espero que et vagi molt bé al blog! 📖 Si vols, també et puc preparar una versió en Markdown més curta per a xarxes socials, o una guia PDF amb captures. Gràcies a tu per la paciència i bona feina! 😊